本文想介绍一下MSE这个优化函数,通过MSE这个损失函数来看机器学习中一些底层的理论。
标准方程
$$
J(\theta)=E[(y-\hat{y})^{2}] \tag{1.1}
$$
公式1.1是均方误差的一个简单的表示,很明显我们就是要求的一个参数能够使得$J(\theta)$最小。最小化的代价函数$J(\theta)$等价于其对$\theta$的梯度为0,则有如下的推导过程
$$\begin{gather}\triangledown J(\theta)=\triangledown E[(y-\theta^{T}x)(y-x^{T}\theta)] \\
=\triangledown[E[y^{2}]-2 \theta^{T} E[xy] +\theta^{T}E[xx^{T}]\theta] \\
=-2p+\phi \theta =0 \tag{1.2}\end{gather}$$
也可以表达为
$$
\phi \theta_{*}=p \tag{1.3}
$$
其中$\theta_{*}$表示最优的参数值。同时也称上面的公式为正规方程。
其中,p是输入和输出的互相关向量。
$$
p=[E[x_{1}y],E[x_{2}y],...,E[x_{l}y]]=E[xy] \tag{1.4}
$$
相应的协方差矩阵为
$$
\phi=E[xx^{T}] \tag{1.5}
$$
如果协方差矩阵是可逆的,就能求解最优线性估计,且解是唯一的,如果是不可逆就有无穷多个解。
特征工程的启发
通过公式1.2对MSE的展开形式, 思考一个有趣的问题, 如果我们想要做一个特征,这个特征符合什么样的特点能够对MSE的收敛更有帮助呢?
这里我们先枚举假设,看看MSE的变化,如果我们加入一个特征X,与Y的相关性较强,与原有的X的相关性也比较强,那么E[XY]增大,但是E[XX]也增大,那么就会导致MSE的变化不可预知是否能变小。当然这就是特征冗余的问题,通过正则项思能解决一部分问题的。
那么假设我们加入一个X’,使得E[XY]增大,但是E[XX]降低,就能十分容易的让MSE减小, 这样的特征的物理概念就是新加入的特征与Y的相关性强,但是与原有的X相关性弱,提供更大的信息增益,所以如果你想找到一个“完美特征”, 你能清楚他的画像吗?
代价函数曲面
根据上文中定义的代价函数可以使用如下的方式表达
$$
J(\theta)=\sigma_{y}^{2}-2\theta^{T}p+\theta^{T} \phi \theta \tag{2.1}
$$
将公式2.1加减$\theta_{\\*}^{T} \phi \theta_{\\*}$
$$\begin{gather}J(\theta)=J(\theta_{\\*})+(\theta-\theta_{\\*}) \phi (\theta-\theta_{\\*}) \tag{2.2}\end{gather}$$
其中$J(\theta_{*})$如下
$$\begin{gathered}J(\theta_{\\*})=\sigma_{y}^{2}-2\theta_{\\*}^{T}p+\theta_{\\*}^{T} \phi \theta_{\\*} \\
=\sigma_{y}^{2}-2\theta_{*}\phi \theta_{\\*}+\theta_{\\*}^{T} \phi \theta_{\\*} \\
=\sigma_{y}^{2}-\theta_{\\*}^{T} \phi \theta_{\\*} \\
=\sigma_{y}^{2}-p^{T}\theta_{\\*} \end{gathered}$$
从上面的公式的能得出一些结论.
- 最优值$\theta_{\\*}$的代价总是小于输出变量的方差$E[y^{2}]$. 如果p=0, 表示x和y不相关。这种情况下,至少就MSE判定标准而言,不能通过观察x对y进行预测。此时的误差与$J(\theta_{\\*})$一致都等于$\sigma_{y}^{2}$,而则表示的是y在均值为0附近的内在不确定性。相反的如果输入和输出有相关关系,可以消除部分y的不确定性。
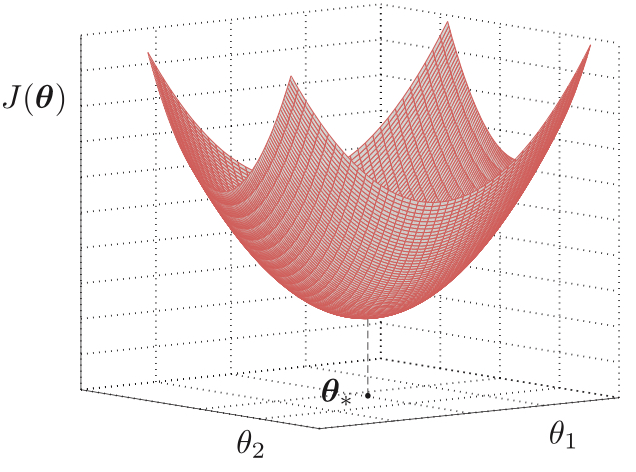
- 除了最优$\theta_{\\*}$外的任何$\theta$值,由于$\phi$的正定性,如公式2.2中,可知,误差的方差是增加的。且代价函数的MSE曲面如下图。是一个椭圆形,形状取决于$\phi$的特征值。
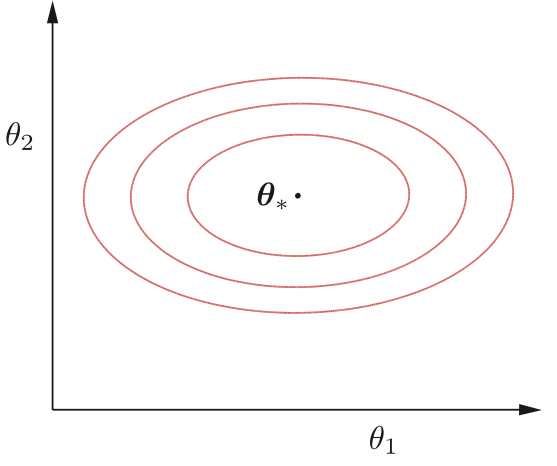
- 如图MSE等高线, 这个等高线的长轴是有输入变量的协方差矩阵$\phi$的最大特征值$\lambda_{max}$决定,短轴是$\lambda_{min}$决定。这里有个小知识点。"最大特征值对应的特征向量方向上包含最多的信息量,如果某几个特征值很小,说明这几个方向信息量很小,可以用来降维,也就是删除小特征值对应方向的数据,只保留大特征值方向对应的数据,这样做以后数据量减小,但有用信息量变化不大"。
下图分别展示了MSE曲面和MSE等高线图。
几何理解
首先我们来了解正交的概念,给定两个不相关的随机变量x和y,如果是其内积为0或者是E[x,y]=0就可以称为正交。那么看3.1
$$
\hat{y}=\theta_{1}x_{1}+...,+\theta_{l}x_{l} \tag{3.1}
$$
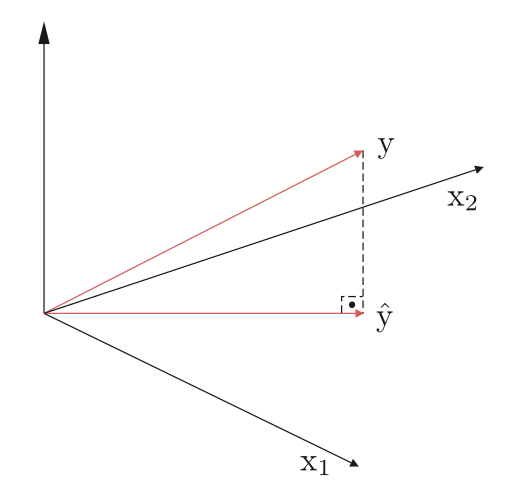
随机变量$\hat{y}$可以解释为向量空间的一个点。它是这个空间中l个元素的组合,因此变量$\hat{y}$必然是这些点张成的自空间中。但是对于真值y却不取决于x的变量,因此我们的目标是想得到一个$\hat{y}$和y的近似,使得$e=y-\hat{y}$的误差最小。可以理解的是当$\hat{y},y$正交的情况下,这个e最小(欧几里得空间内,直线最短),如下图。也就是
$$\begin{gathered}E[e k_{k}]=0 \\
k=1,2,3..,l\end{gathered}$$
上面的公式又可以写成
$$\begin{gathered}E[(y-\sum_{i=1}^{l} \theta_{i})x_{k}] =0 \\
或者 \\
\sum_{i=1}^{l}E[x_{k}x_{i}]\theta_{i}=E[x_{k}y]\end{gathered}$$
上面这个公式也是正规方程的一种表达形式,也就是说MSE想要表达是当前输入变量x与y的相关关系,能够通过x的子协方差矩阵和参数$\theta$表达,就能预测出最好的误差效果。
线性回归的例子
$$\begin{gathered}y=\theta_{o}x+\eta \\
\theta_{o} \in R^{k}\end{gathered}$$
其中$\eta$是一个与x独立的零均值噪声变量,如果真实系统中$\theta_{o}$的维度k能够等于l,也就是把相关的变量全部刻画全,k=l,那么就可能拟合到最优值
$$\begin{gathered}\theta_{o}=\theta_{\\*}\end{gathered}$$
且最优MSE等于噪声的方差。
滤波
滤波经常也会在机器学习的任务中被提及,也是通过MSE的方式作为评价标准,下面介绍下滤波的三种问题。
- 滤波,在时刻n的估计是基于所有的先前的接受数据信息。
- 平滑,收到到时间区间[0,N]内的数据得到每个时刻n<N的估计
- 预测,基于知道包括时刻n的数据,得到n+x的时间估计