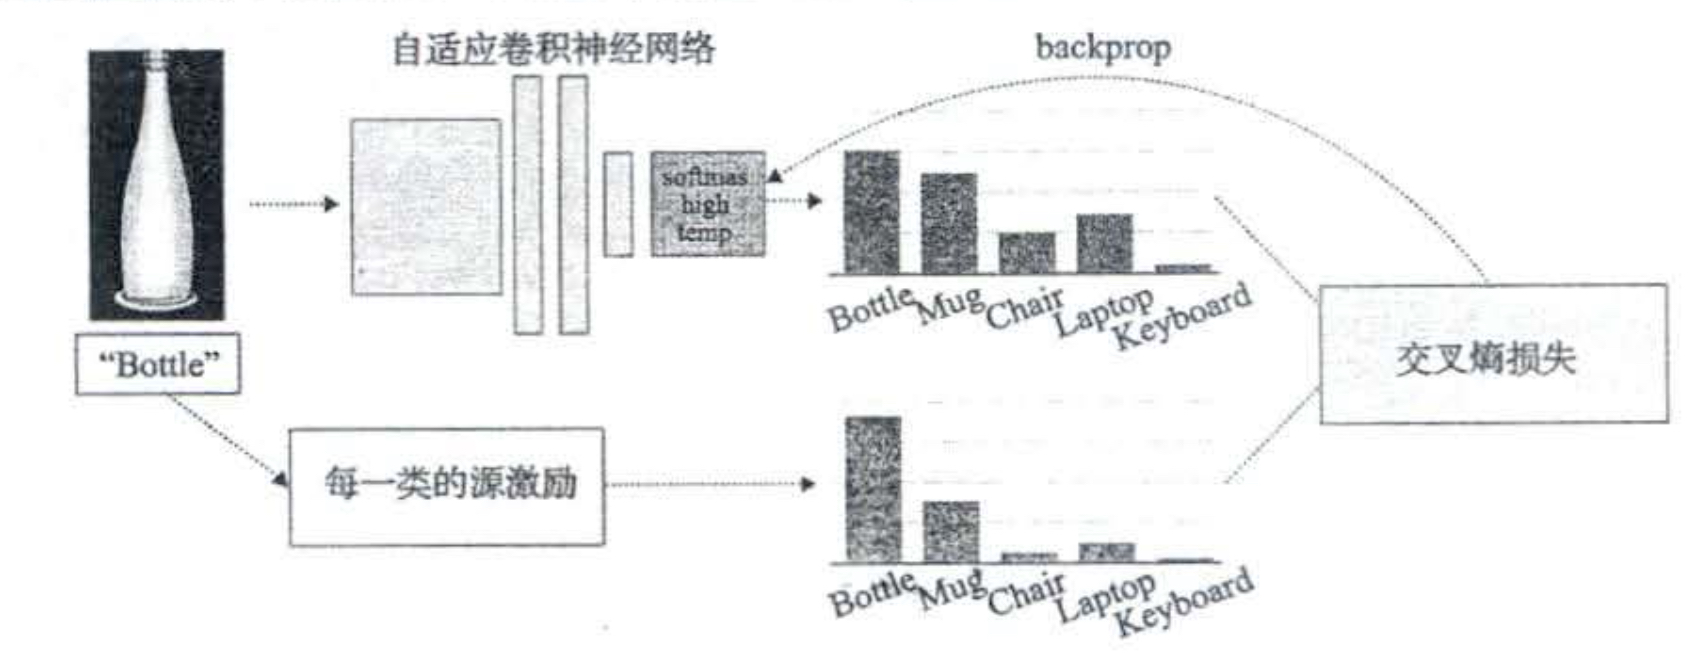
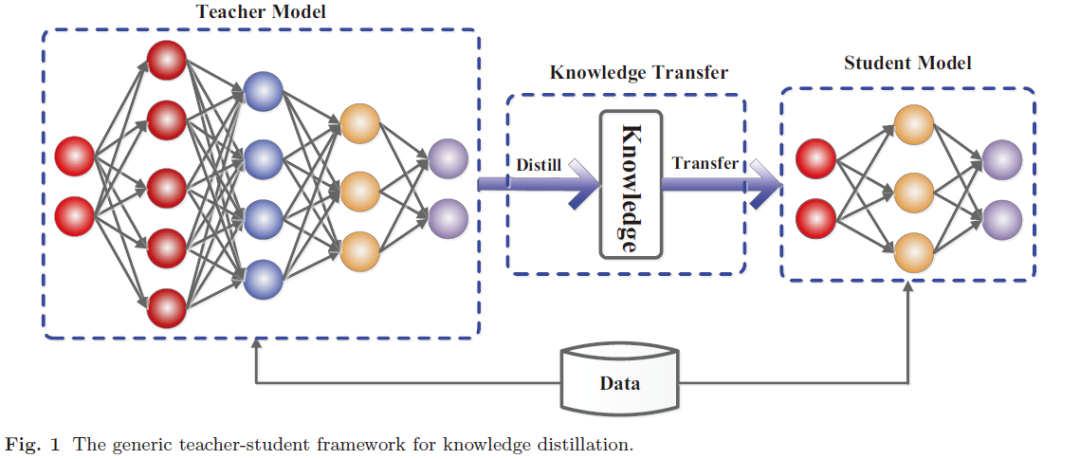
[{"source":{"position":0,"lines":["本章其实在元学习系列已经进行一个大部分的讲解,所谓的基于模型的迁移是说如果在已有的模型中抽取出对当前学习有效的知识,而这里所谓的知识就是权重。下面就轻量级的讲点之前没有提到的东西"],"changePosition":null},"target":{"position":0,"lines":["本章介绍基于几何特征变换的迁移学习, 与统计特征迁移不同的是考虑到数据中经常存在一种空间几何结构,这个时候通过空间几何结构能够简洁而有效迁移获得相应的结果。几何变换有以下几种方法,分别是子空间变化和流行空间变换以及最优传输法。接下里的内容就一一介绍这些内容。","# 问题定义","我们再来看迁移学习的统一表现形式。","$$\begin{gathered}","f^{\\\\*}=arg\\ min \\frac{1}{N_{s}} \\sum_{i=1}^{N_{2}} L(v_{i}f(x_{i}),y_{i})+\\lambda R(T(D_{s}), T(D_{t})) \\tag{1.1}","\end{gathered}$$"],"changePosition":null},"type":"CHANGE"},{"source":{"position":2,"lines":["# 基于贝叶斯的迁移学习","基于贝叶斯的迁移学习目前应用在一些自然语言处理的任务中。使用在文本分类任务,一般如下两个步骤。","1. 以概率分布的形式对先验的知识进行迁移。利用朴素贝叶斯在源域的数据中建立模型。","2. 该算法使用EM算法求解目标域模型,使用KL散度度量两个域的差异。多轮推演减少新学习的模型与目标分布的差异。这其实就是一个相对学习的过程。"],"changePosition":null},"target":{"position":7,"lines":["这里在考虑变换函数T的时候,往往从数据的几何特征出发,最终还是围绕同样的目标进行优化。","## 子空间变换法","子空间变换法通常假设源域和目标域在数据变换以后有着相似的分布。而自空间是可以进行数据的分布对齐,这里介绍一种最简单的自空间迁移法的方式SA, SA算法直接寻找一个线性变换M,将$X_{s}, X_{t}$分别表示源域和目标域经过PCA以后的数据,前d维特征向量组成的特征矩阵,用这个特征向量表示其子空间。SA的优化目标如下","$$\begin{gathered}","F(M)=|X_{s}M-X_{t}|^{T} \\tag{2.1}","\end{gathered}$$","M是可以通过变换和学习获得。由于子空间的变换的正交性,$X_{s}X{t}=I$, 可以对上述的优化直接求解","$$\begin{gathered}","F(M)=|X_{s}^{T}X_{s}-X_{s}^{T}X_{t}|^{2}=|M-X_{s}^{T}X_{t}|^{2} \\tag{2.2}","\end{gathered}$$","这样可以直接求的M。","我们通过求解一个转换矩阵M,使其能够对源域和目标域的特征进行转换后距离相近,那么使用这个子空间进行分类,优化这个分类效果就可以优化模型进行目标域的分类。 其他的方法都是基于此类方法进行改进,这里就不在赘述啦。","## 流形学习","流形学习引入了许多的新的概念,其核心思想是在源域和目标域中间找到几个点,然后一步一步的将源域的知识迁移到目标域,从而达成迁移学习的目标。"," ","最早期的方法是SGF(sampling geodesic flow)的方法,但是存在一个超参数d的问题,d是中间取几个点的问题,后来在测地线流式核方法中获得解答,而且还解决了如果存在多个源域的情况下,使用哪个源域来做迁移的决策(Rank of Domain)。这里的方法大家如果感兴趣可以自行调研,这里就不过多展开啦。","## 最优传输法","最优传输问题的描述是有M个仓库起火啦, 需要往这M个仓库调用消防队员,现有的消防队员分布在N个仓库中,如何调用能够用最小化的成本解决N个仓库的火灾。进一步形式化定义N个仓库需要的消防员数量为$H_{i}$,位置为$y_{i}$, 而这个N个仓库的消防员数量为$G_{i}$,位置为$x_{i}$, 最后任意两个仓库的距离是$c(x_{i}, y_{j})$。那么优化的目标是","$$\begin{gathered}","min \\sum_{i,j=1}^{N,M} T_{i,j} c(x_{i}, y_{i}) \\\\","s.t. \\sum_{j} T_{ij}=G_{i}\\\\","\\sum_{i} T_{ij}=H_{j}\\\\","\end{gathered}$$","$T_{i,j}$表示到N个仓库的消防员数。通过描述这个背景相信大家已经有点感觉知道怎么做这个迁移学习的方案啦, 从一个分布最小化的代价迁移到另一个分布不就是迁移学习的本质吗?","## 最优传输到迁移学习","反映到迁移学习上,对应于需要做到一个映射函数,能够保证用最小化的代价将源域映射到目标域中。"],"changePosition":null},"type":"CHANGE"},{"source":{"position":7,"lines":["# 利用深度学习迁移","在深度学习中,往往使用知识蒸馏的方式进行知识迁移,知识蒸馏涉及到一个教师网络和一个学生网络,标签也是软标签,最初是为模型压缩提出的。在处理压缩的过程中,源域和目标域被认为是一致的。","","基于深度的迁移学习中,通过计算类别k所有源样本的激励函数的平均值,可以提取类别k的软标签l。下图就是一个例子,其中向量的每个维度表示bottle和每个类别的相似性,通过学习发现bottle的软标签和杯子的权重比键盘的更高。通过训练这样的软标签,可以刻画bottle,杯子,键盘的特征空间的关系","","
 ","","# 知识蒸馏","知识蒸馏,可以将一个网络的知识转移到另一个网络,两个网络可以是同构或者异构。做法是先训练一个teacher网络,然后使用这个teacher网络的输出和数据的真实标签去训练student网络。知识蒸馏,可以用来将网络从大网络转化成一个小网络,并保留接近于大网络的性能;也可以将多个网络的学到的知识转移到一个网络中,使得单个网络的性能接近emsemble的结果。","","
 ","","蒸馏模型的一般框架,在典型的图像分类任务中,logit(例如深层神经网络中最后一层的输出)被用作教师模型中知识的载体,而训练数据样本未明确提供该模型。例如,猫的图像被错误地归类为狗的可能性非常低,但是这种错误的可能性仍然比将猫误认为汽车的可能性高很多倍。另一个示例是,手写数字2的图像与数字3相比,与数字7更相似。这种由教师模型学习的知识也称为暗知识(“dark knowledge”)。一般会将logit替换成如下的形式。防止标签过硬,T是超参数。","","
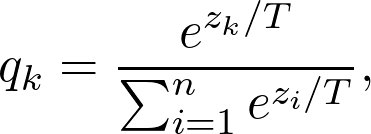 ","","","1. 训练一个能够性能很好泛化也很好的大模型。这被称为教师模型。","2. 利用你所拥有的所有数据,计算出教师模型的预测。带有这些预测的全部数据集被称为_知识_,预测本身通常被称为_soft targets_。这是知识蒸馏步骤。","3. 利用先前获得的知识来训练较小的网络,称为学生模型。","","","",""],"changePosition":null},"target":{"position":34,"lines":["$$\begin{gathered}","D(P,Q)=\\int_{X \\times Y} π(x,y)c(x,y)dxdy \\tag{3.1}","\end{gathered}$$","这个公式标的是对于分布P和Q,有很多种迁移方案π(运筹方案),每种方案的成本是c(x,y), 一般大家函数是$c(x,y)=|x-y|^{2}$, 所以转化以后就变成了","$$\begin{gathered}","D(P,Q)=\\int_{X \\times Y} π(x,y)|x-y|^{2}dxdy \\tag{3.2}","\end{gathered}$$","不同于传统的特征变化方法,最优的传输研究问题是学习一个源域到目标域的点一点的关联矩阵T, 经过T的变换后,源域能够用最小化的代价变成目标域。 现在就关键点就变成了矩阵T如何获得的问题?最优传输通常是使用变换代价来衡量变换成本C(T).","$$\begin{gathered}","C(T)=\\int c(x,T(x))d \\mu(x) \\tag{3.3}","\end{gathered}$$"," $\\mu(x)$表示数据分布,c(x,T(x))表示代价函数,也可以是距离函数。进一步抽象"," $$\begin{gathered}"," \\gamma_{0}=arg\\ min \\int_{S \\times T} c(x_{s}, x_{t}) d \\gamma((x_{s}, x_{t}))"," \end{gathered}$$"," "," $\\gamma$表示一种迁移策略。这里其实通过一个运筹策略,求解源域到目标域的最小代价迁移策略。"," 当我们使用的时候就可以使用这种迁移方案,将源域的输入进行加权(方案)进行学习。这样的模型就能在目标域使用啦。"," "," # 总而言之"," 最后整体看看本节的迁移学习, 核心思路其实没有任何变化,不管是几何变换还是特征变换,最终都是拉近源域和目标域的距离,能够通过源域的学习代替目标域的学习。"],"changePosition":null},"type":"CHANGE"}]