现在我们可以回顾一下原来的知识,我们之前讲了那么多的算法,但是我们是不是都有一个假设,就是我们的状态空间都是有限的。然后我们使用内存存储每个状态的值函数,不断的进行更新这个值函数。如果是一个无限空间的场景我们将如何处理呢?这个时候已经没有足够的内存啦,我们往往需要使用近似的函数$V(s,\theta)$,利用函数逼近的方法对值函数表示。
$$
V(s)=V(s,\theta)
$$
其中$\theta$表示引入的参数,实际上是一个向量,通过函数近似,可以少量的参数$\theta$来拟合实际的各种值函数。
线性逼近
所谓的线性逼近指的是值函数表示为状态或者状态函数的线性组合。
$$
V(s,\theta)=\theta^T x(s)=\sum_{i=1}^{d} \theta_i x_i(s) \tag{7.1}
$$
其中x(s)表示状态s的特征分量。 例如我们如果想把飞机飞行状态表示成状态空间,需要描述角速度、飞行速度等等。
假设每个状态s对应k个数,$s=(s_1.s_2,...s_k)$则对于这个k维状态空间,函数$x_{i}(s)$可以写成。
$$
x_i(s) = s_j \tag{7.2}
$$
上面的表达十分简单,但是忽略了不同维度特征之间的相互作用,因此需要对函数x(s)进行扩展,使其不仅能表示状态特征分量,还能表示更加复杂的函数,如多项式函数等。这里就类似于SVM的核函数的意义,这里就不再赘述啦。大家只要理解除了原始的特征以外还可以经过加工变成维度更加丰富的特征就可以啦。
增量法
进行值函数逼近的时候,我们希望学到值函数尽可能近似真实的值函数,近似程度常用最小二乘法来度量。
$$
E_{\theta}=E_{\pi}[(V_{\pi}(s)-\theta^{T}x(s))^2] \tag{7.3}
$$
为了使得误差最小化,尝尝采用梯度下降方法,对误差求负倒数。
$$
\frac{\partial E_{\theta}}{\partial \theta}=E_{\pi}[2(V_{\pi}(s)-\theta^{T}x(s))x(s)]
$$
$$
\nabla \theta= \alpha(V_{\pi}(s)-\theta^{T}x(s))x(s)
$$
但是进行逼近的时候,我们并不知道逼近的目标,是不是谈到重点啦,就是真实的$V_{\pi}(s)$取值,这个时候我们可以考虑使用任意一个无模型方法对$V_{\pi}(s)$进行评估。
这样就可以将值函数过程看成一个监督学习的过程,标签就是蒙特卡洛方法中$G_{t}$,时序差分中就是$R_{t+1}+\gamma V(S_{t+1})$,在多步差分中就是$G_{t}^{\lambda}$
基于蒙特卡洛方法的参数逼近
给定策略π产生一个完整的轨迹
$$
(s_0,a_0,r_0,s_1,a_1,r_1,...)
$$
值函数更新的过程实际上是一个监督的过程,其实监督数据集中的累计回报$G_t$从蒙特卡洛的轨迹中就能得到,回报$G_t$可以通过$r_i$求得,所以轨迹也可以表示为如下的数据集合
$$
(s_0,G_0),...(s_n,G_n)
$$
更新的公式就是
$$
\nabla \theta= \alpha(G_t-\theta^{T}x(s_t))x(s_t) \tag{7.4}
$$
基于时序差分的参数逼近
如果考虑使用一步时序差分的方法,从不完整的轨迹中学习参数值,就需要用到自举的方法,用下一步状态的值函数更新当前的值函数。TD(0)方法中目标函数为:$R_{t+1}+\gamma V(S_{t+1})$.其中$V(S_{t+1})$可以用$V(S_{t+1},\theta)$近似。
同样将值函数更新看成监督学习过程。
$$
(s_0,R_{1}+\gamma V(S_{1},\theta))...(s_t,R_{T+1}+\gamma V(S_{T+1},\theta))
$$
此时主要要更新的参数$\theta$,不仅出现在要估计的当前状态值函数中$V(S,\theta)$也出现在目标值函数中$V(S_{t+1},\theta)$。对$\theta$求导时,只考虑对估计值函数$V(S,\theta)$的影响而忽略对目标值函数的影响,就是仅仅保留$V(S,\theta)$对$\theta$的导数,而忽略目标函数对$theta$的导数,这种方法并不是完全的梯度法,而是部分梯度法。
其更新公式为
$$
\nabla \theta= \alpha(R_{t+1}+\gamma \theta^{T}x(s_{t+1})-\theta{T}x(s_t))x(x_t) \tag{7.5}
$$
基于前向$TD(\lambda)$的参数逼近
考虑多步时序差分前向算法进行参数逼近,$\lambda$-回报 $G_{t}^{\lambda}$是值函数的无偏估计对应监督学习数据集为
$$
<s_0,G_{0}^{\lambda}>,<s_1,G_{1}^{\lambda}>,<s_2,G_{2}^{\lambda}>,<s_3,G_{3}^{\lambda}>
$$
参数更新公式为
$$
\nabla \theta=\alpha(G_{t}^{\lambda}-\theta^{T}x(s_t))x(s_t)
$$
基于后向$TD(\lambda)$的参数逼近
对于后向算法有
$$\begin{gathered}\delta_t=R_{t+1}+\gamma \theta^{T}x(s_{t+1})-\theta^{T}x(s_t) \\
E_t=\lambda \gamma E_{t-1} + \nabla_{\theta} V(S_t,\theta)=\lambda \gamma E_{t-1}+x(s_t)\end{gathered}$$
不知道大家发现没有,这个和我们之前的定义已经发生了变化,运来我们的定义是
$E_t=\lambda \gamma E_{t-1} +1$,这个是表格型强化学习,但是非表格强化学习中,资格迹变成了$\nabla_{\theta} V(S_t,\theta)$
$$
\nabla \theta=\alpha \delta_t E_t
$$
在实际场景中,大多数情况下我们需要逼近行为值函数以便获取策略。
$$
Q(s,a,\theta) \approx Q(s,a)
$$
将$\theta$作用于状态和动作的联合向量上,即给状态向量增加一维用于存放动作向量,即将函数x(s)替换为x(s,a),这样就有了行为值函数
$$
Q(s,a,\theta)=\theta^{T}x(s,a)=\sum \theta_{i}x_{i}(s,a)
$$
对于近似值和实际值采用最小二乘误差来度量,为了使误差最小,对其误差采用梯度下降算法。
$$\begin{gathered}E_{\theta}=E_{π}[(Q^{π}(s,a)-\theta^{T}x(s,a))^2] \\
-\frac{\partial E_{\theta}}{\partial \theta}=E_{π}[2(Q^{π}(s,a)-\theta^{T}x(s,a))x(s,a)]\end{gathered}$$
对于单个样本更新规则为
$$
\nabla \theta=\alpha(Q^{π}(s,a)-\theta^{T}x(s,a)) x(s,a)
$$
对应的$Q(s,a)$是未知的,可以使用蒙特卡洛、时序差分等进行评估。
基于蒙特卡洛参数逼近的公式为
$$
\nabla \theta=\alpha(G_t-\theta^{T}x(s_t,a_t))x(s_t,a_t)
$$
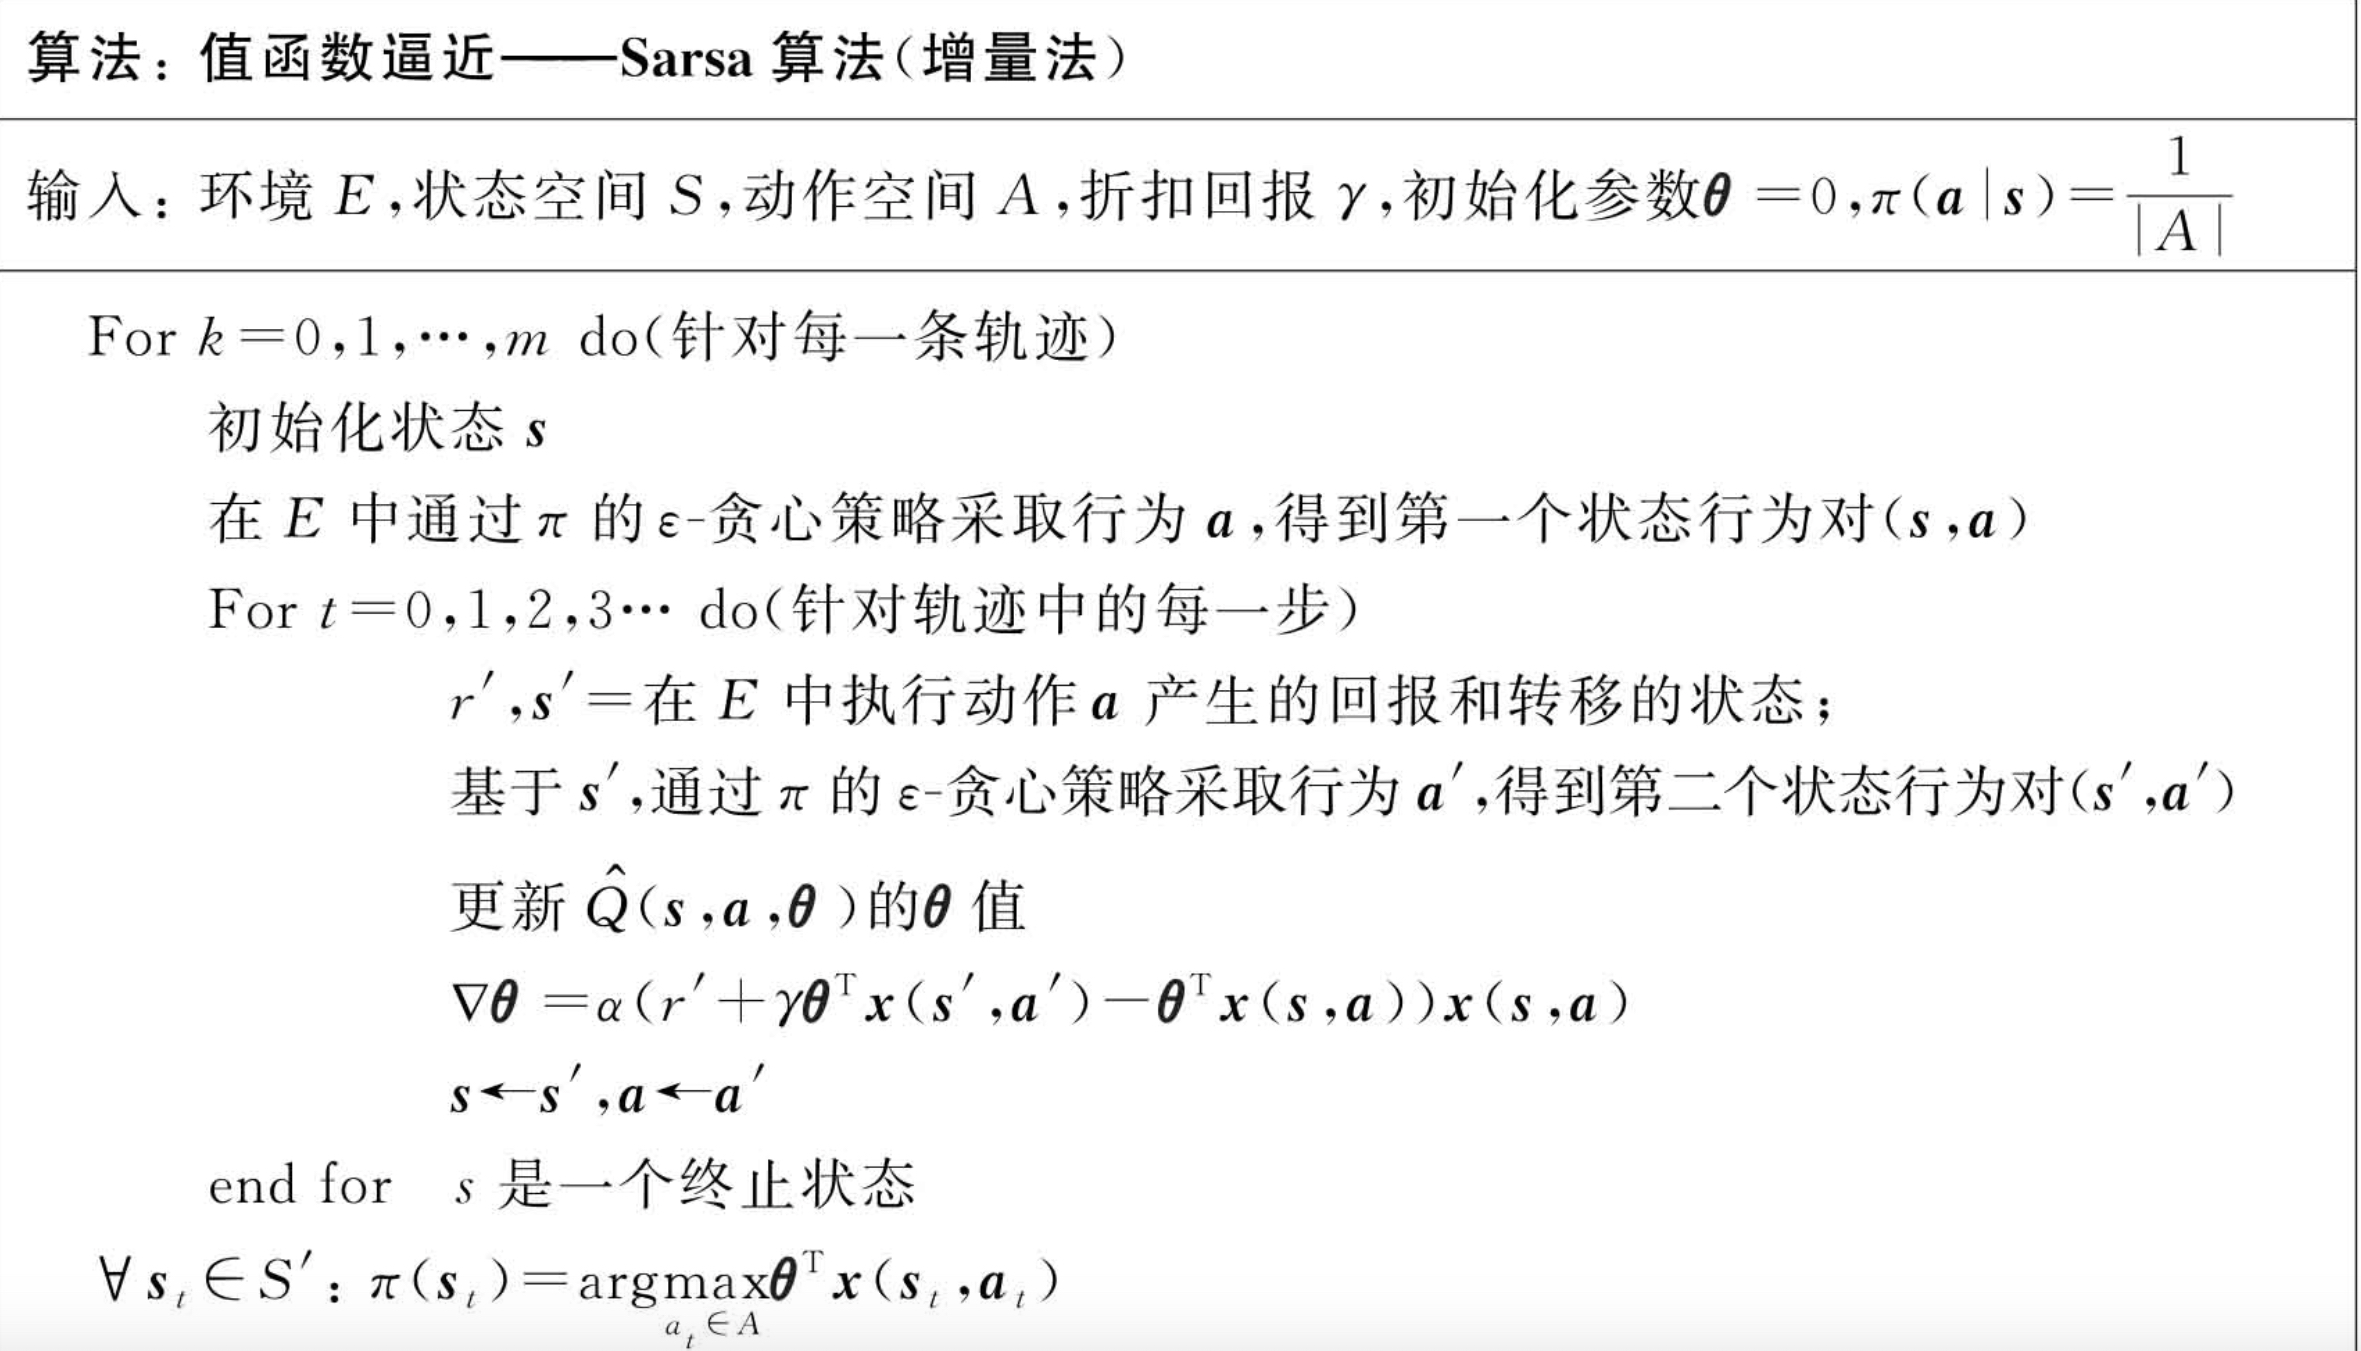
基于sarsa参数逼近为
$$
\nabla \theta=\alpha(R_{t+1}+\gamma \theta^{T}x(s_{t+1},a_{t+1}-\theta^{T}x(s_t,a_t)))x(s_t,a_t)
$$
基于Q学习的参数逼近
$$
\nabla \theta=\alpha(R_{t+1}+\gamma \theta^{T}x(s_{t+1},π(s_{t+1})-\theta^{T}x(s_t,a_t)))x(s_t,a_t)
$$
基于前向算法的参数逼近
$$
\nabla \theta=\alpha(q_{t}^{\lambda}-\theta^{T}x(s_t,a_t))x(s_t,a_t)
$$
基于后向算法的参数逼近
$$\begin{gathered}\delta_t=R_{t+1}+\gamma \theta^{T}x(s_{t+1},a_{t+1})-\theta^{T}x(s_{t},a_{t}) \\
E_t=\lambda \gamma E_{t+1} + \nabla_{theta}Q(s_t,a_t,\theta)=\lambda \gamma E_{t-1}+x(s_{t},a_{t}) \\
\nabla \theta=\delta_t \alpha E_t\end{gathered}$$
以上讲的就是增量法更新。以下是sarsa的增量更新伪代码。
批量法
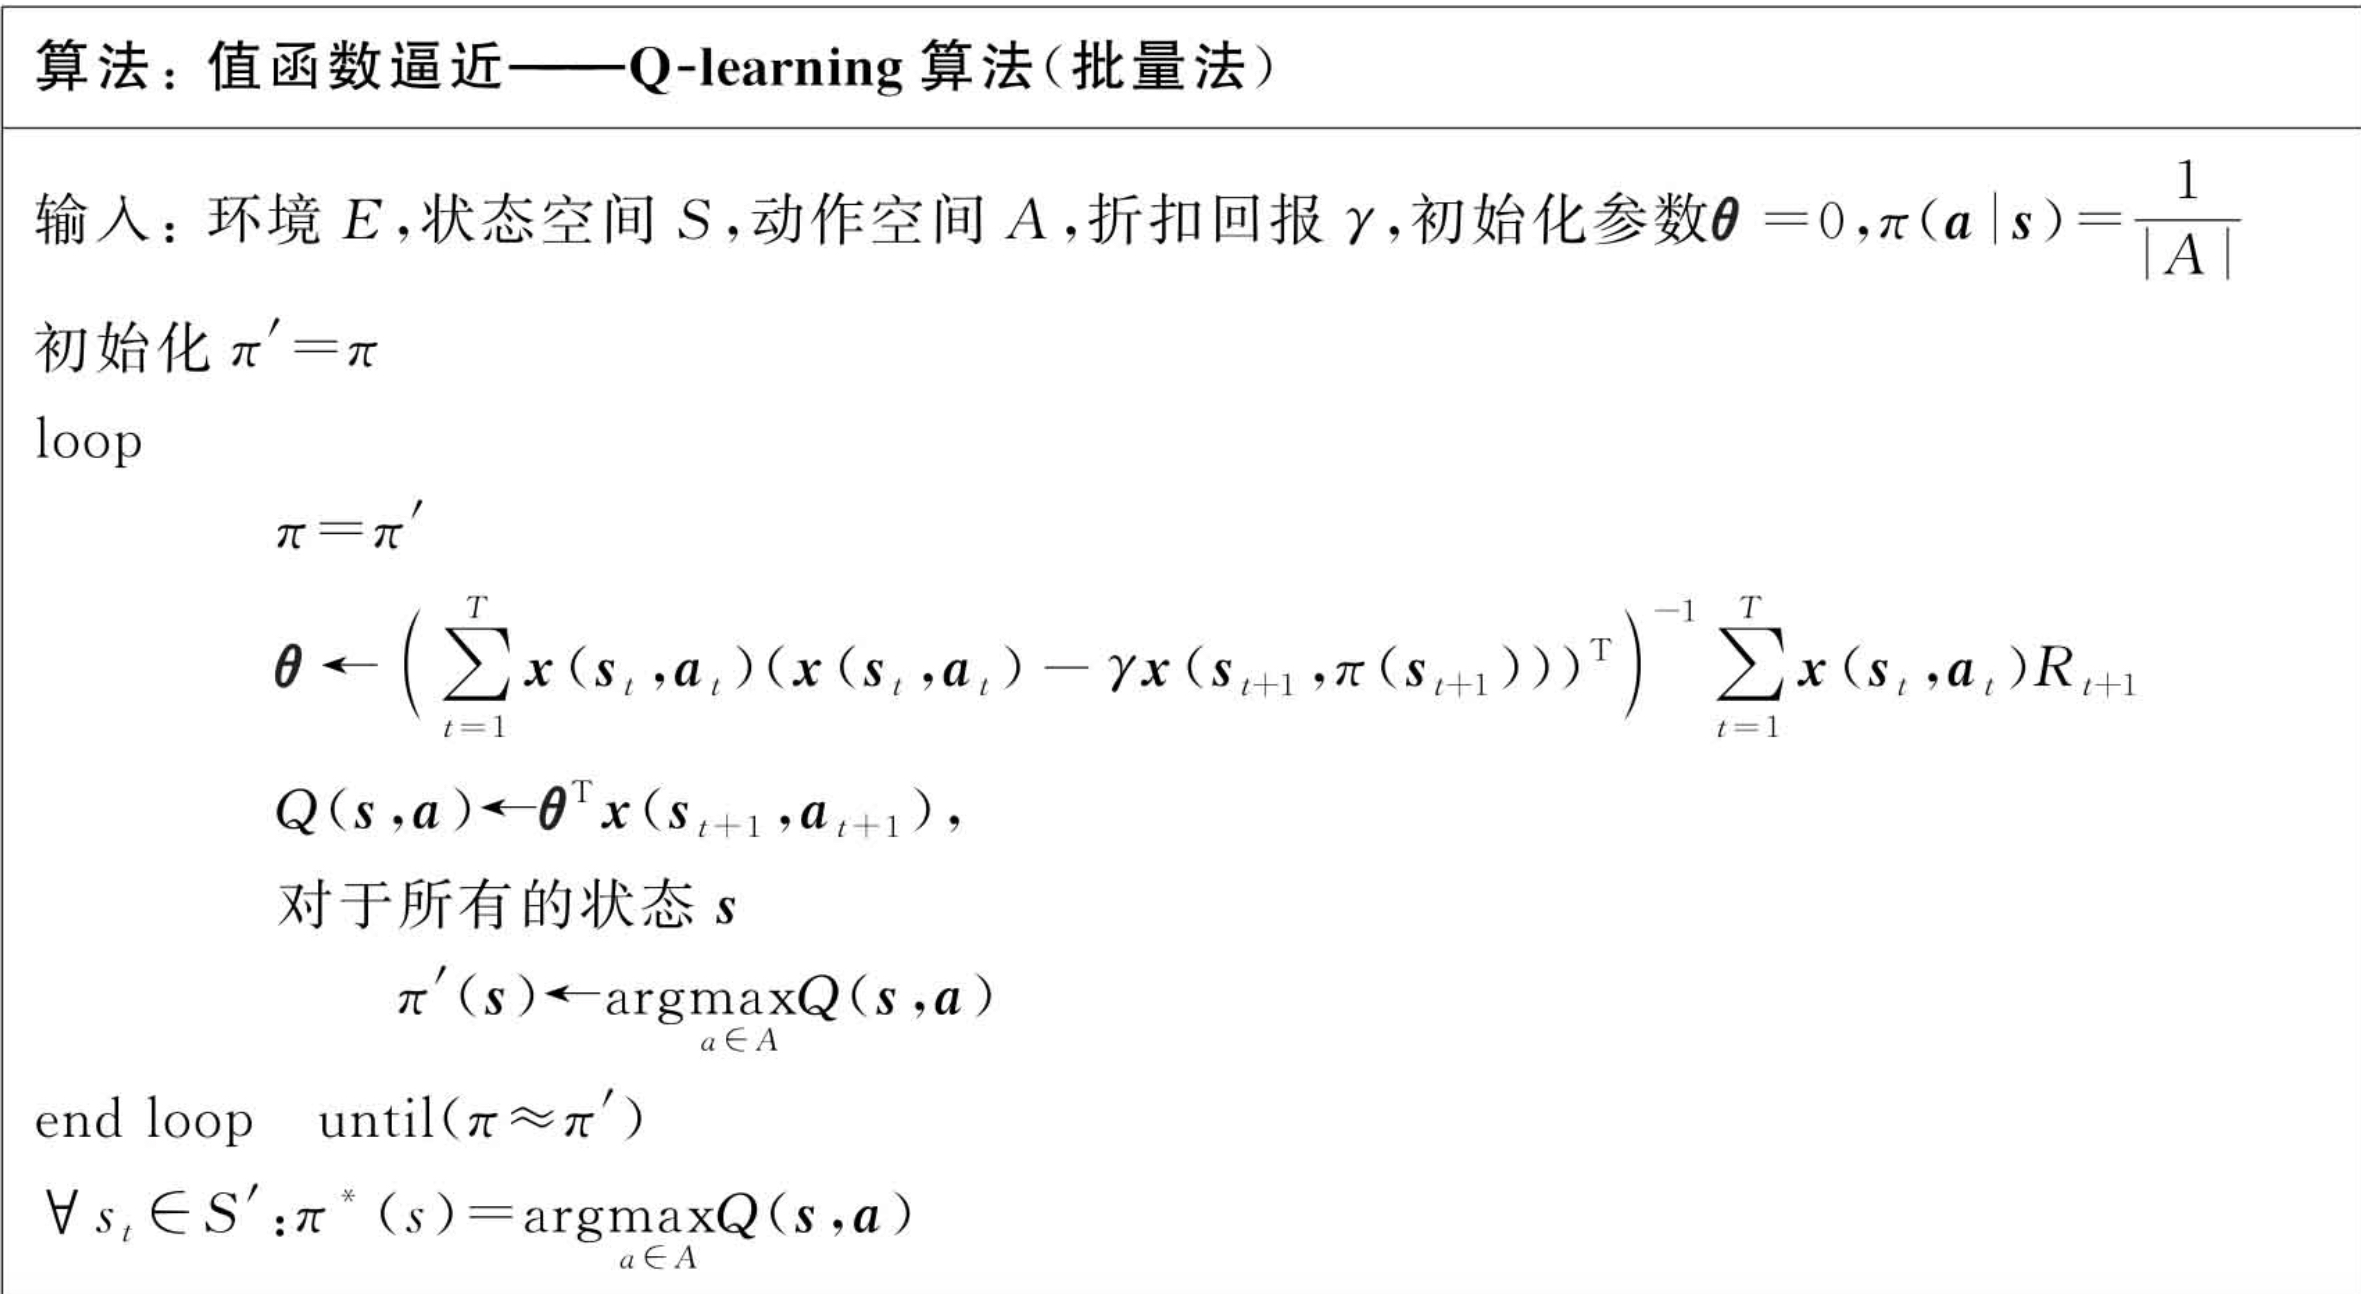
我们之前讨论的增量法在更新过程中随机性非常大,尽管计算简单,单样本数据利用效率不高。而批量法尽管计算复杂但是利用率较高。
批量法是把一段时间的数据集中起来,给定一段经验数据$D=\{(s_1,V_{1}^π),(s_2,V_{2}^π),(s_2,V_{3}^π)\}$
满足损失最小
$$\begin{gathered}L(\theta)=\sum (V_{t}^{π}-\theta^{T}x(s_t))^2 \\
\frac{\partial L(\theta)}{\partial \theta}=2\sum (V_{t}^{π}-\theta^{T}x(s_t))x(s_t)=0\end{gathered}$$
同样的我们总结一下各种方法对$V_{t}^{π}$的进行近似。
蒙特卡洛方法
$$\begin{gathered}\alpha \sum_{t=1}^{T} (G_t-\theta^{T} x(s_t)) x(s_t) = 0 \\
\theta=(\sum_{t=1}^{T} x(s_t) x(s_t)^T)^{-1} \sum_{t=1}^{T} x(s_t)G_t\end{gathered}$$
时序差分
$$\begin{gathered}\alpha \sum_{t=1}^{T}(R_{t+1}+\gamma \theta^{T}x(s_{t+1})-\theta^{T}x(s_{t}))x(s_{t})=0 \\
\theta=(\sum_{t=1}^{T}x(s_{t})(x(s_{t})-\gamma x(s_{t+1}))^T )^{-1} \sum_{t=1}^{T} x(s_{t}) R_{t+1}\end{gathered}$$
前向$TD(\lambda)$
$$\begin{gathered}\alpha \sum_{t=1}^{T}(G_{t}^{\lambda}-\theta^T x(s_{t}) )x(s_{t}) =0 \\
\theta=(\sum_{t=1}^{T}x(s_{t})x(s_{t})^T )^{-1} \sum_{t=1}^{T} x(s_{t}) G_{t}^{\lambda}\end{gathered}$$
后向$TD(\lambda)$
$$\begin{gathered}\alpha \delta_t E_t=0\\
\theta=(\sum_{t=1}^{T} E_t(x(s_{t})-\gamma x(s_{t+1}))^{T})^{-1} \sum_{t=1}^{T} E_t R_{t+1}\end{gathered}$$
如果对行为值函数进行拟合,就是$Q(s,a,\theta) \approx Q(s,a) $并对数据集$D={, Q_{1}^{π},..,, Q_{T}^{π}}$应用批量法
蒙特卡洛方法
$$\begin{gathered}\alpha \sum_{t=1}^{T} (G_t-\theta^{T} x(s_t)) x(s_t) = 0 \\
\theta=(\sum_{t=1}^{T} x(s_t,a_t) x(s_t,a_t)^T)^{-1} \sum_{t=1}^{T} x(s_t,a_t)G_t\end{gathered}$$
sarsa方法
$$\begin{gathered}\alpha \sum_{t=1}^{T}(R_{t+1}+\gamma \theta^{T}x(s_{t+1},a_{t+1})-\theta^{T}x(s_{t},a_{t}))x(s_{t},a_{t})=0 \\
\theta=(\sum_{t=1}^{T}x(s_{t},a_{t})(x(s_{t},a_{t})-\gamma x(s_{t+1},a_{t+1}))^T )^{-1} \sum_{t=1}^{T} x(s_{t},a_{t}) R_{t+1}\end{gathered}$$
Qlearning方法
$$\begin{gathered}\alpha \sum_{t=1}^{T}(R_{t+1}+\gamma \theta^T x(s_{t+1},π(s_{t=1}))-\theta^T x(s_{t},a_{t}))x(s_{t},a_{t})=0 \\
\theta=(\sum_{t=1}^{T}x(s_{t},a_{t})(\sum_{t=1}^{T}x(s_{t},a_{t})-\gamma x(s_{t+1},π(s_{t+1})))^T)^{-1} \sum_{t=1}^{T} x(s_{t},a_{t}) R_{t+1}\end{gathered}$$
前向$TD(\lambda)$
$$\begin{gathered}\alpha \sum_{t=1}^{T}(G_{t}^{\lambda}-\theta^T x(s_{t},a_{t}) )x(s_{t},a_{t}) =0 \\
\theta=(\sum_{t=1}^{T}x(s_{t},a_{t})x(s_{t},a_{t})^T )^{-1} \sum_{t=1}^{T} x(s_{t},a_{t}) G_{t}^{\lambda}\end{gathered}$$
后向$TD(\lambda)$
$$\begin{gathered}\alpha \delta_t E_t=0\\
\theta=(\sum_{t=1}^{T} E_t(x(s_{t},a_{t})-\gamma x(s_{t+1},a_{t+1}))^{T})^{-1} \sum_{t=1}^{T} E_t R_{t+1}\end{gathered}$$