通过这一个系列的学习,是否发现学习了很多东西,又好像啥也没学到,学习经常就是这样一个状态,第一个学习的时候往往都是伪装自己明白啦,当某个时间点真正用到了,才知道原来这些知识能够这样的使用,本章咱们就为Qlearning讲解一个例子,方便我们理解。
放学去网吧
下面这个例子,咱们举一个放学去网吧的例子吧,空间图如下图。左上角的小孩就是你,中间的是老师,碰到老师肯定就不会让你去网吧啦,右下角的是最终目标带着同学一起去网吧,其他的格子都是同学,你的目标就是带着更多的动作去网吧,快乐加倍!那么问题来啦,怎么选择这个路径呢?
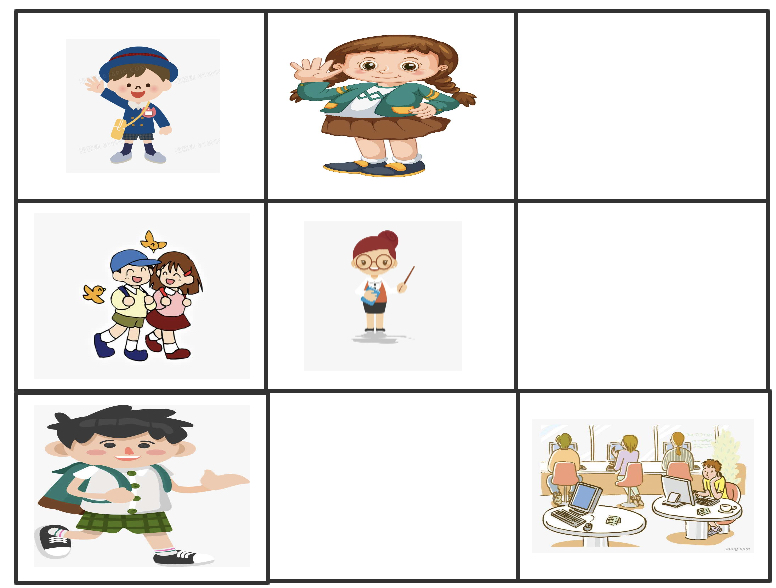
通过上面的这个例子,咱们就来还原整个Qlearning的学习过程。那么我们来看看收益表格,
一个同学 = +1
两个同学 = +2
到达网吧 = +10(训练结束)
遇到老师 = -10(训练结束)
状态空间从左上角的格子开始编号1,每一行都是从左到右依次递增。网吧是9,老师是5,你的右边的女同学是2.那么构建初始化的Q表如下。
| 状态 |
左 |
右 |
上 |
下 |
| 1 |
0 |
0 |
0 |
0 |
| 2 |
0 |
0 |
0 |
0 |
| 3 |
0 |
0 |
0 |
0 |
| 4 |
0 |
0 |
0 |
0 |
| 5 |
0 |
0 |
0 |
0 |
| 6 |
0 |
0 |
0 |
0 |
| 7 |
0 |
0 |
0 |
0 |
| 8 |
0 |
0 |
0 |
0 |
| 9 |
0 |
0 |
0 |
0 |
- 初始化如上的Q表
- 选择一个动作。从起始点,你可以在向右走和向下走其中选择一个。如果是初始的表,开始Q值都是相等,这里可以随机选择一个,这里我们寻找往右边的女同学方向走。
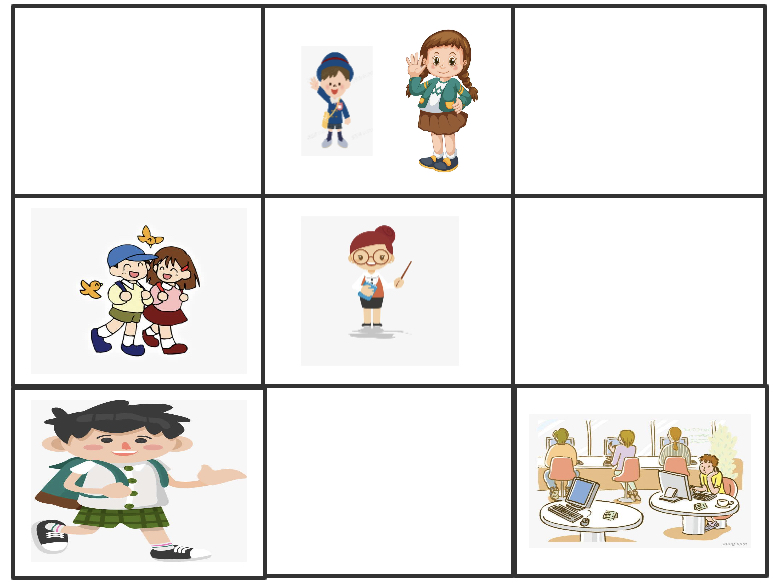
- 获得一个同学同行,快乐加倍。这是我们更新Q值,并继续向右走,到位置3.
这里我们就要看看,怎么更新这个Q值啦。
$$
Q(s,a)=Q(s,a)+ \alpha(R(s,a)+\beta \ max Q'(s',a')-Q(s,a))
$$
其中$\alpha=0.1$是学习率, $\beta=0.9$是折扣因子。
根据上面的公式
$$\begin{gathered}newQ=Q(1,right)+\alpha \Delta Q(1, right) \\
\Delta Q(1, right)=R(1, right)+\beta max[Q'(2,a')] - Q(1,right) \\
\Delta Q(1, right) = 1+0.9 * max[Q(2, right), Q(2, down),Q(2, left)]-Q(1, right) \\
\Delta Q(1, right) = 1+0.9*0 -0 =1\end{gathered}$$
$$
newQ =0+0.1*1=0.1
$$
可以将学习率看作是网络有多快地抛弃旧值、生成新值的度量。如果学习率是 1,新的估计值会成为新的 Q 值,并完全抛弃旧值。
按照上面的计算,我们就生成了如下新的Q表,现在我们要做的就是一次又一次地做这个工作直到学习结束。
| 状态 |
左 |
右 |
上 |
下 |
| 1 |
0 |
0.1 |
0 |
0 |
| 2 |
0 |
0 |
0 |
0 |
| 3 |
0 |
0 |
0 |
0 |
| 4 |
0 |
0 |
0 |
0 |
| 5 |
0 |
0 |
0 |
0 |
| 6 |
0 |
0 |
0 |
0 |
| 7 |
0 |
0 |
0 |
0 |
| 8 |
0 |
0 |
0 |
0 |
| 9 |
0 |
0 |
0 |
0 |
总结一下
通过上面的描述学习,是不是知道实际的Q学习中应该如何更新Q表了呢?前面的讲解实在晦涩难懂,就用这个例子加深一下印象吧。