节咱们举例子讲到如何计算马尔可夫的值函数,本章节主要介绍一些常用的算法。
值迭代算法
对$i \in S$通过计算
$$
v^{n+1}(i)=max_{a \in A(i)}\{r(i,a)+\beta \sum_{j \in S} p(j|i,a)v^{n}(j)\}
$$
如果
$$
v^{n+1}(i)-v^{n}(i)<\frac{\sigma(1-\beta)}{2\beta}
$$
进入下一步,否则n+1
$$
f_{i} \in arg\ max\{r(i,a)+\beta \sum_{j \in S}p(j|i,a)v^{n+1}(j)\}
$$
上面就是介绍的值函数的迭代方式,和上面举例子一致,下面顺便给出一个定理。
$v^{n}$是通过值迭代函数算法得到的序列,对于值迭代算法的整体收敛情况有如下的结论。
- 值迭代算法的一步收敛速度是$\beta$
- 值迭代算法的平均收敛速度是$\beta$
- 对于一切n,都有如下的关系$|v^{n}-v_{beta}^{*}|<\frac{\beta^{n}}{1-\beta} |v^{1}-v^{0}|$
从上面的定理我们能够看出收敛的速度其实是局限与$\beta$的,当$\beta=1$的时候,收敛速度会受到极大的影响,这个是就要引出我们要介绍的另一个算法,分解迭代算法以增加迭代数据。它的核心思路是固定策略f后,将上一篇博客提到的 $I-\beta P(f)$分解成两部分。这里说一下是上节提到的策略迭代的手法。
$$
I-\beta P(f)=Q(f)-R(f)
$$
上面的分解称为正规分解,最简单的正规分解是$Q(f)=I,R(f)=\beta P(f)$. 下面这个算法也称为高斯赛尔德值迭代算法
step1, k=1
step2,
$$
v^{n+1}(i_{k})=max_{a \in A(i_{k})}\ \{r(i_{k},a) + \beta[\sum_{j<k}] p(i_{k}|i_{k},a)v^{n+1}(i_{j})+\sum_{j>k}p(i_{j}|i_{k},a)v^{n}(i_{j})\}
$$
如果k=N, 进入step3, 否则k+=1
step3,
$$
v^{n+1}(i)-v^{n}(i)<\frac{\sigma(1-\beta)}{2\beta}
$$
进入下一步,否则n+1
step4,
$$
f_{i} \in arg\ max\{r(i,a)+\beta \sum_{j \in S}p(j|i,a)v^{n+1}(j)\}
$$
大家发现没有,后半部分和原来是一模一样的,只是开头的时候,通过k将状态的累积汇报进行了一次拆解。
改进的策略迭代算法
我们知道在求解值函数的过程中,我们是需要求解一个线性方程的,当线性方程未知数范围较大的时候,复杂度是不太能够被接受的,所以移除了咱们下面这种策略,改进的策略迭代算法,重申一下,策略迭代是在上节中讲到的。
step1, 策略迭代
$$
f_{n+1} \in arg\ max[r(f)+\beta P(f) v^{n}]
$$
如果可能就取$f_{n+1}=f_{n}$
step2,部分策略迭代,重置k=0,令
$$
\mu_{n}^{0}=max[r(f), \beta P(f) v^{n}]
$$
如果满足$\mu_{n}^{0}-v^{n}<\frac{\sigma(1-\beta)}{2\beta}$,就结束,
如果$k=m_{n}$,重置$v^{n+1}=\mu_{n}^{m_{n}}$,将n+=1, 进入step1,否则使用下面公式计算$\mu_{n}^{k+1}$.
$$
\mu_{n}^{k+1=}=r(f_{n+1})+\beta P(f_{n+1}) \mu_{n}^{k}
k+=1
$$
马氏决策和线性规划
本节中我们要介绍马氏决策和线性规划的关系,当状态空间N有限的时候,对于所有的$f \in F$满足,
$$
v>r(f)+\beta P(f) v
$$
那么v就是MDP的值函数上界,所以根据这个定义,咱们就可以建立线性规划方程。
$$\begin{gathered}min\ \sum_{i \in S} \frac{1}{N} v(i) \\
s.t. \\
v(i)>r(i,a)+\beta \sum_{j \in S}p(j|i,a) v(j) \\\end{gathered}$$
约束条件之前咱们已经说过啦,这个目标函数是什么意思呢?它实际想表达的是用$\frac{1}{N}$表示转移到每个状态的概率是相同的。约束条件已经表达了最优化的准则,所以目标函数最小化这个准则下的解就可以啦。我们可以通过对偶问题来看看上面的线性规划。
$$\begin{gathered}max\ \sum_{i \in S} \sum_{a \in A(i)} r(i,a) x(i,a) \\
s.t. \\
\sum_{i \in S} \sum_{a \in A(i)} [\delta(i,j)-\delta p(j|i,a)]x(i,a)=\frac{1}{N} \\\end{gathered}$$
这里定义$\delta(i,j)=0,\delta(i,i)=1$
这是一个标准对偶转化。可以参见下面的转化公式。
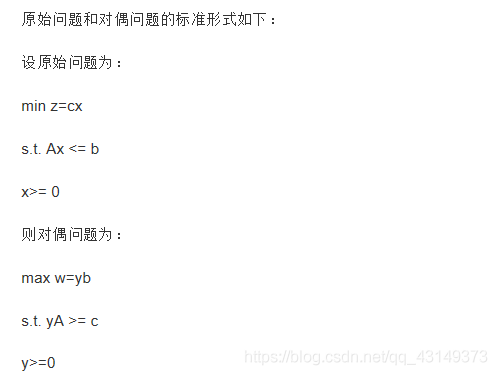
这里我们发现原来序列决策问题其实也能够转化为线性规划问题,似乎都是属于运筹规划的部分,所以解决这个问题的时候,是不是能够更加灵活的解决这样的问题。